

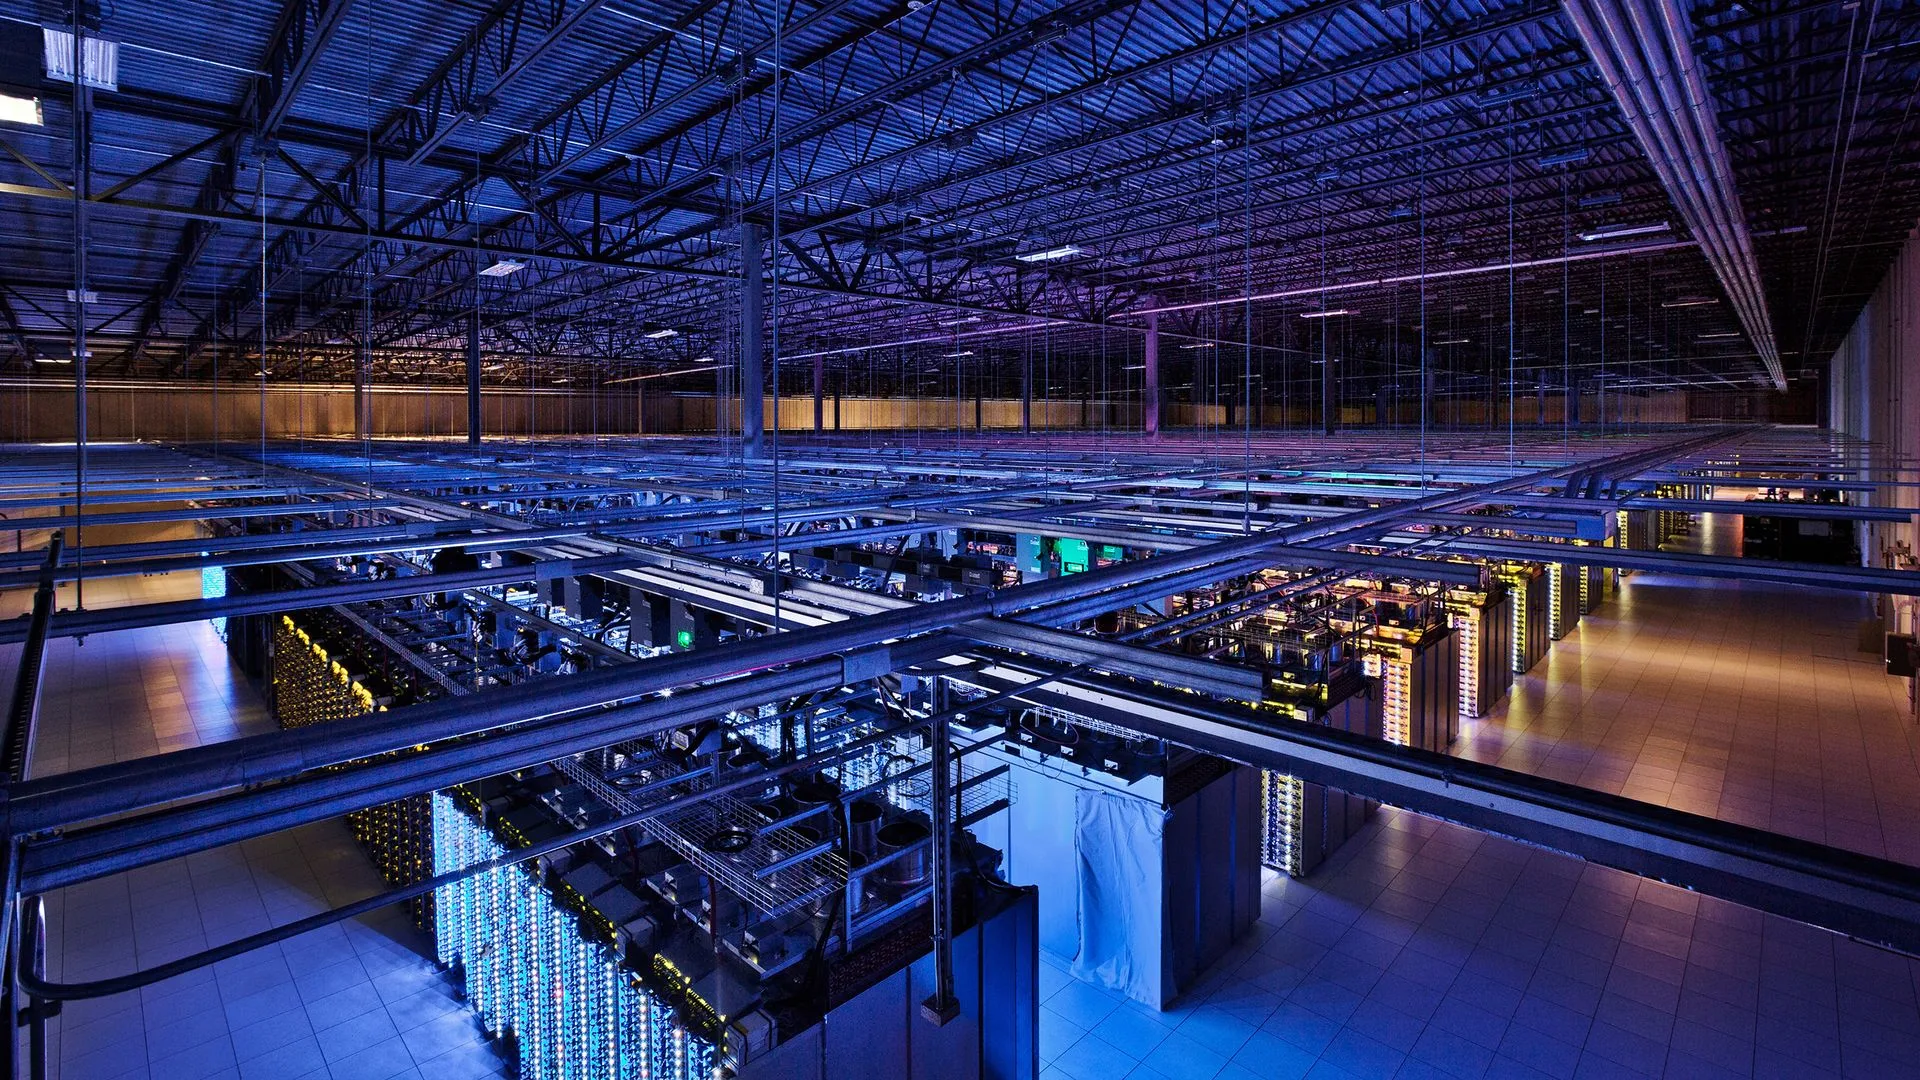
Szybki rozwój klastrów AI wymusza na infrastrukturze obliczeniowej przekroczenie fizycznych i energetycznych ograniczeń pojedynczych centrów danych. W trakcie konferencji Supercomputing 2026, badacze z Ohio State University omówili ewolucję technologii wysokowydajnych sieci, podkreślając, że efektywne rozproszone obliczenia na tak dużą skalę wymagają znacznie więcej niż szybszych połączeń sieciowych. Kluczowe jest rozciąganie obciążenia na różne centra danych w różnych regionach geograficznych.
Współczesne klastry AI zazwyczaj obsługują ponad 100 000 akceleratorów AI oraz miliony punktów CPU, co stawia ogromne wymagania dotyczące przepustowości sieci, opóźnień i zarządzania przeciążeniem. Wzrost wydajności obliczeniowej akceleratorów jest szybszy niż możliwości komunikacyjne, co oznacza, że szybsze GPU AI nie zawsze przekładają się na proporcjonalne poprawy wydajności aplikacji. Dlatego efektywność infrastruktury sieciowej decyduje o tym, jak skutecznie duże systemy AI mogą wykorzystywać swoje zasoby obliczeniowe.
Tradycyjnie systemy wysokowydajne korzystały z dwóch głównych domen interkonektów: scale-up i scale-out. Jednak masowa wielkość i zużycie energii nowoczesnych klastrów AI stwarzają popyt na trzecią domenę interkonektów, znaną jako scale-across, która pozwala na łączenie zasobów obliczeniowych z różnych lokalizacji, co jest kluczowe w kontekście ograniczeń związanych z dostępnością energii czy chłodzeniem w pojedynczych centrach danych. Google, Cisco i Marvell już pracują nad technologiami umożliwiającymi takie rozwiązania, co może zrewolucjonizować sposób, w jaki infrastruktura AI będzie rozwijana w przyszłości.
Więcej informacji pod linkiem: Źródło newsa